功能
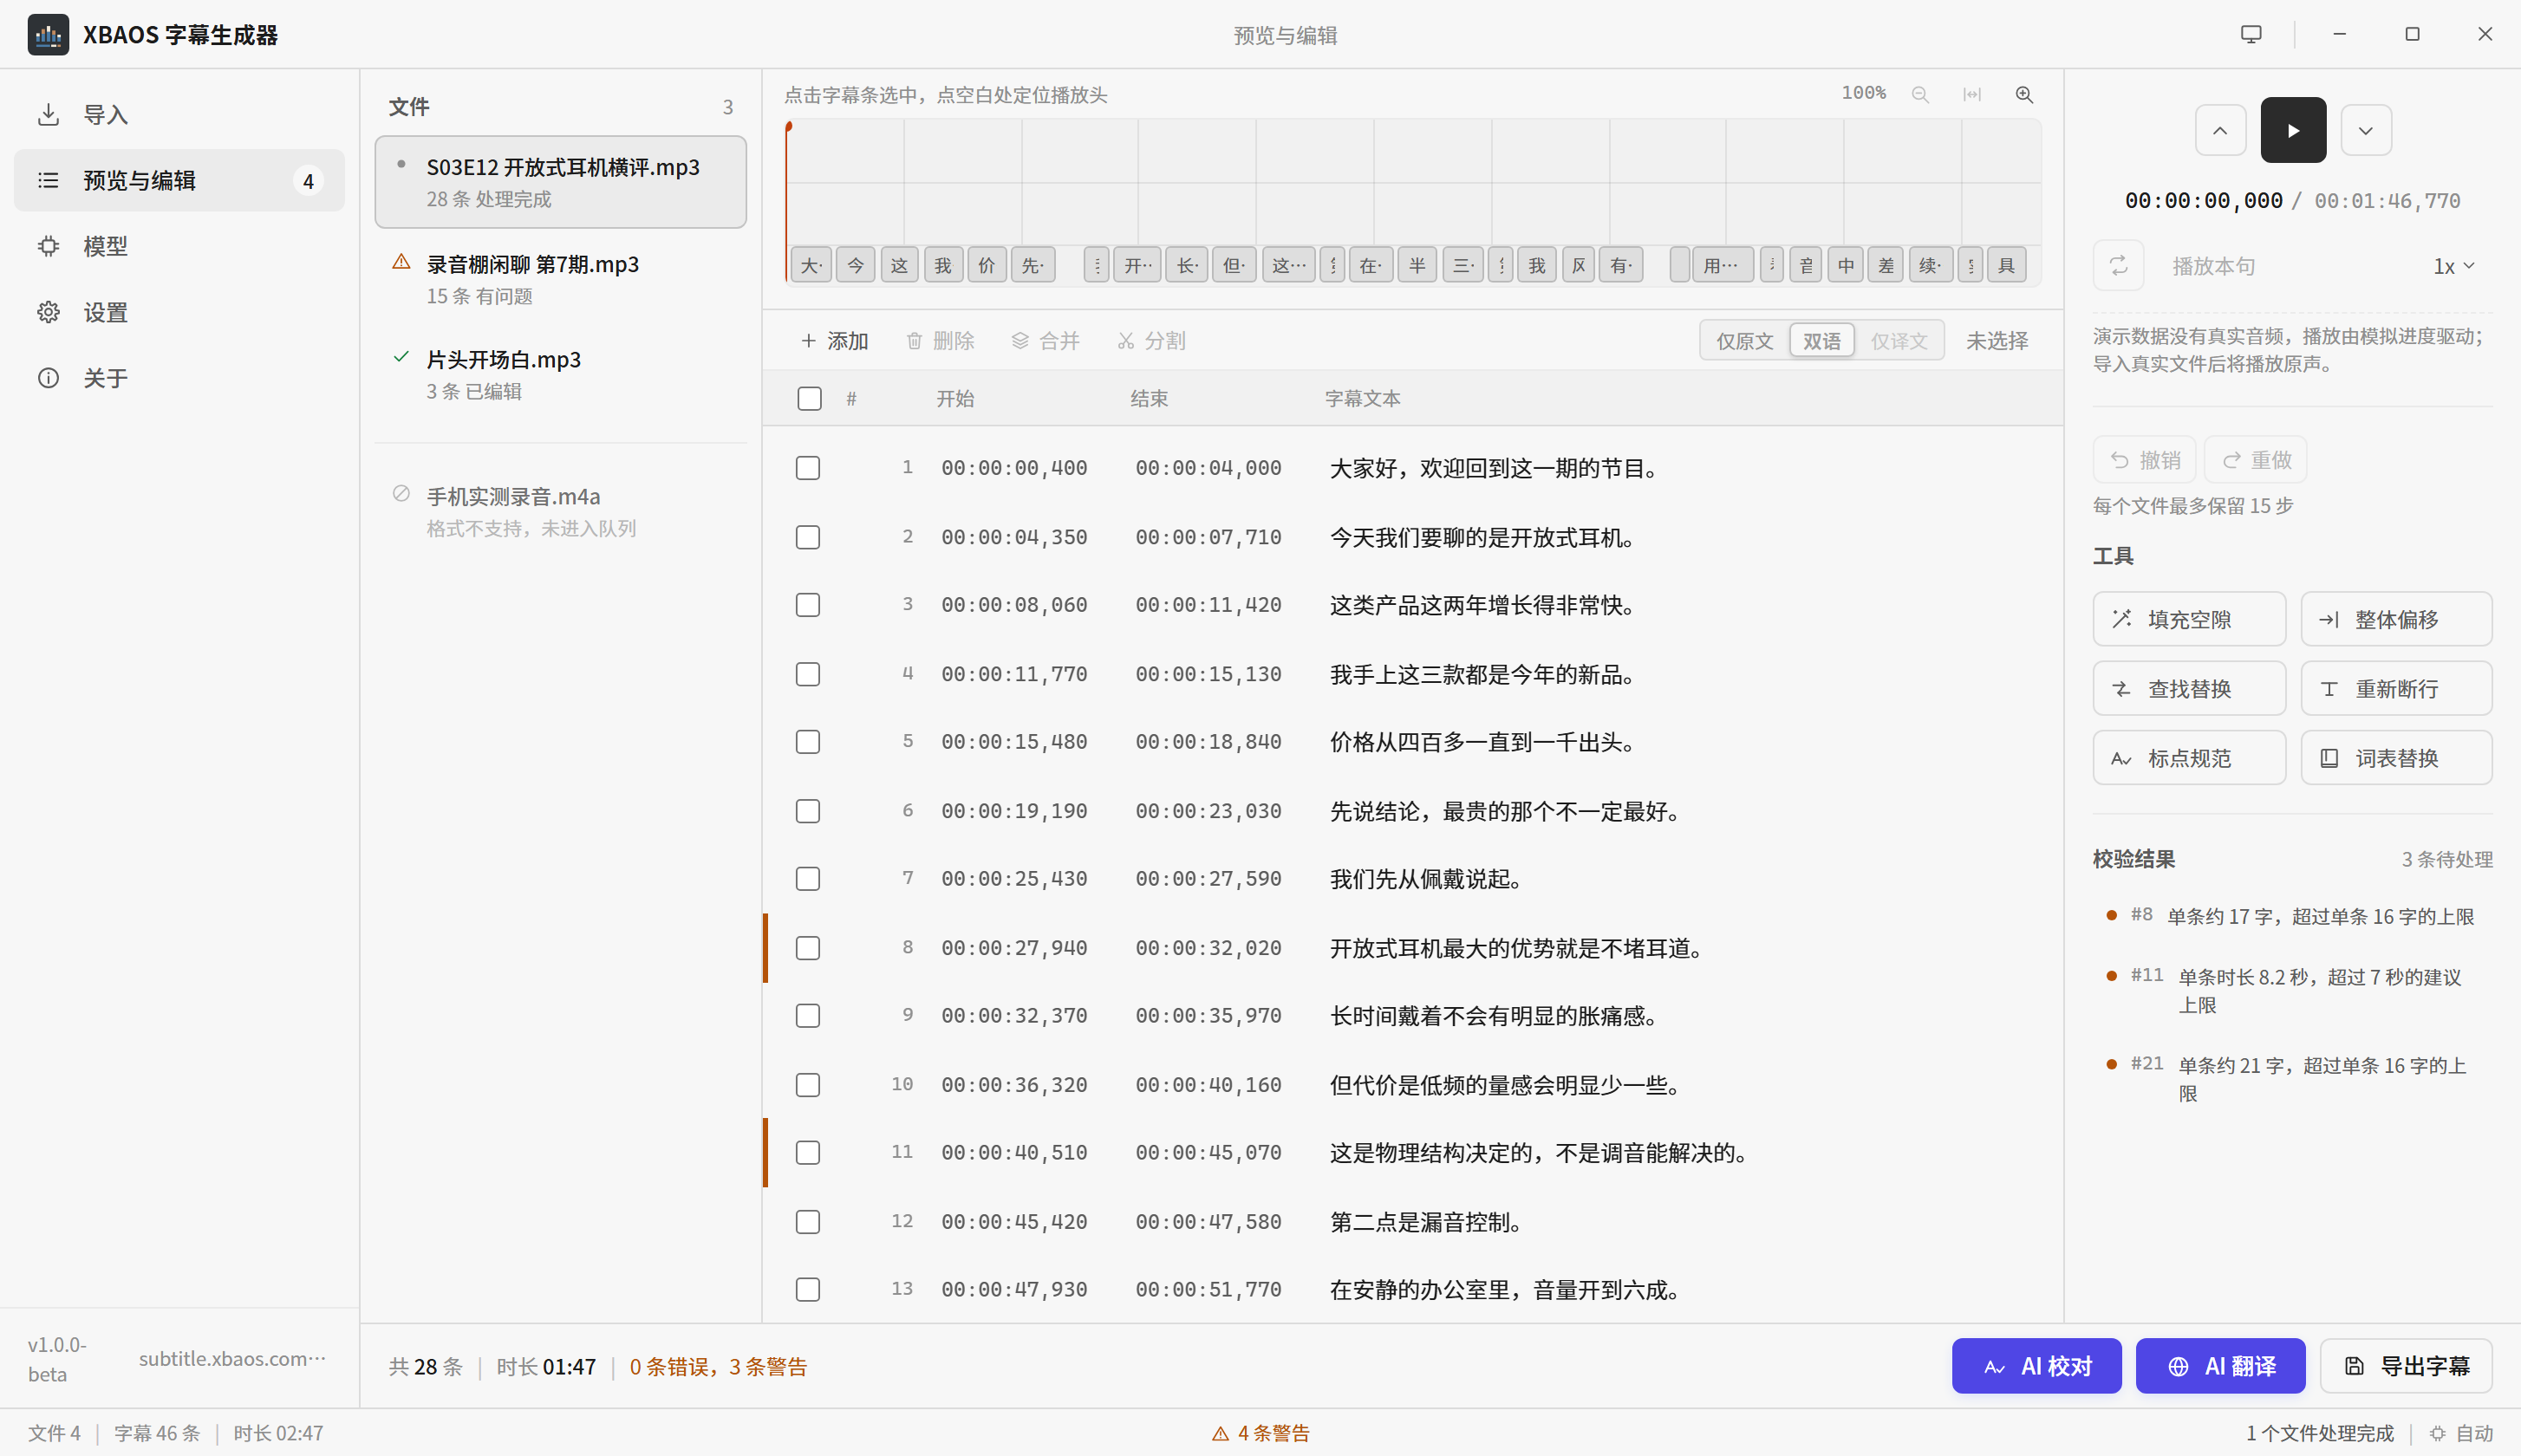
该做的事,都在同一条流水线里
不做「能识别就行」的半成品。识别前后该做的事 —— 语音切分、电平归一化、 专有名词校正、字幕规格校验 —— 都在同一条链路里。
拖进来就能开始
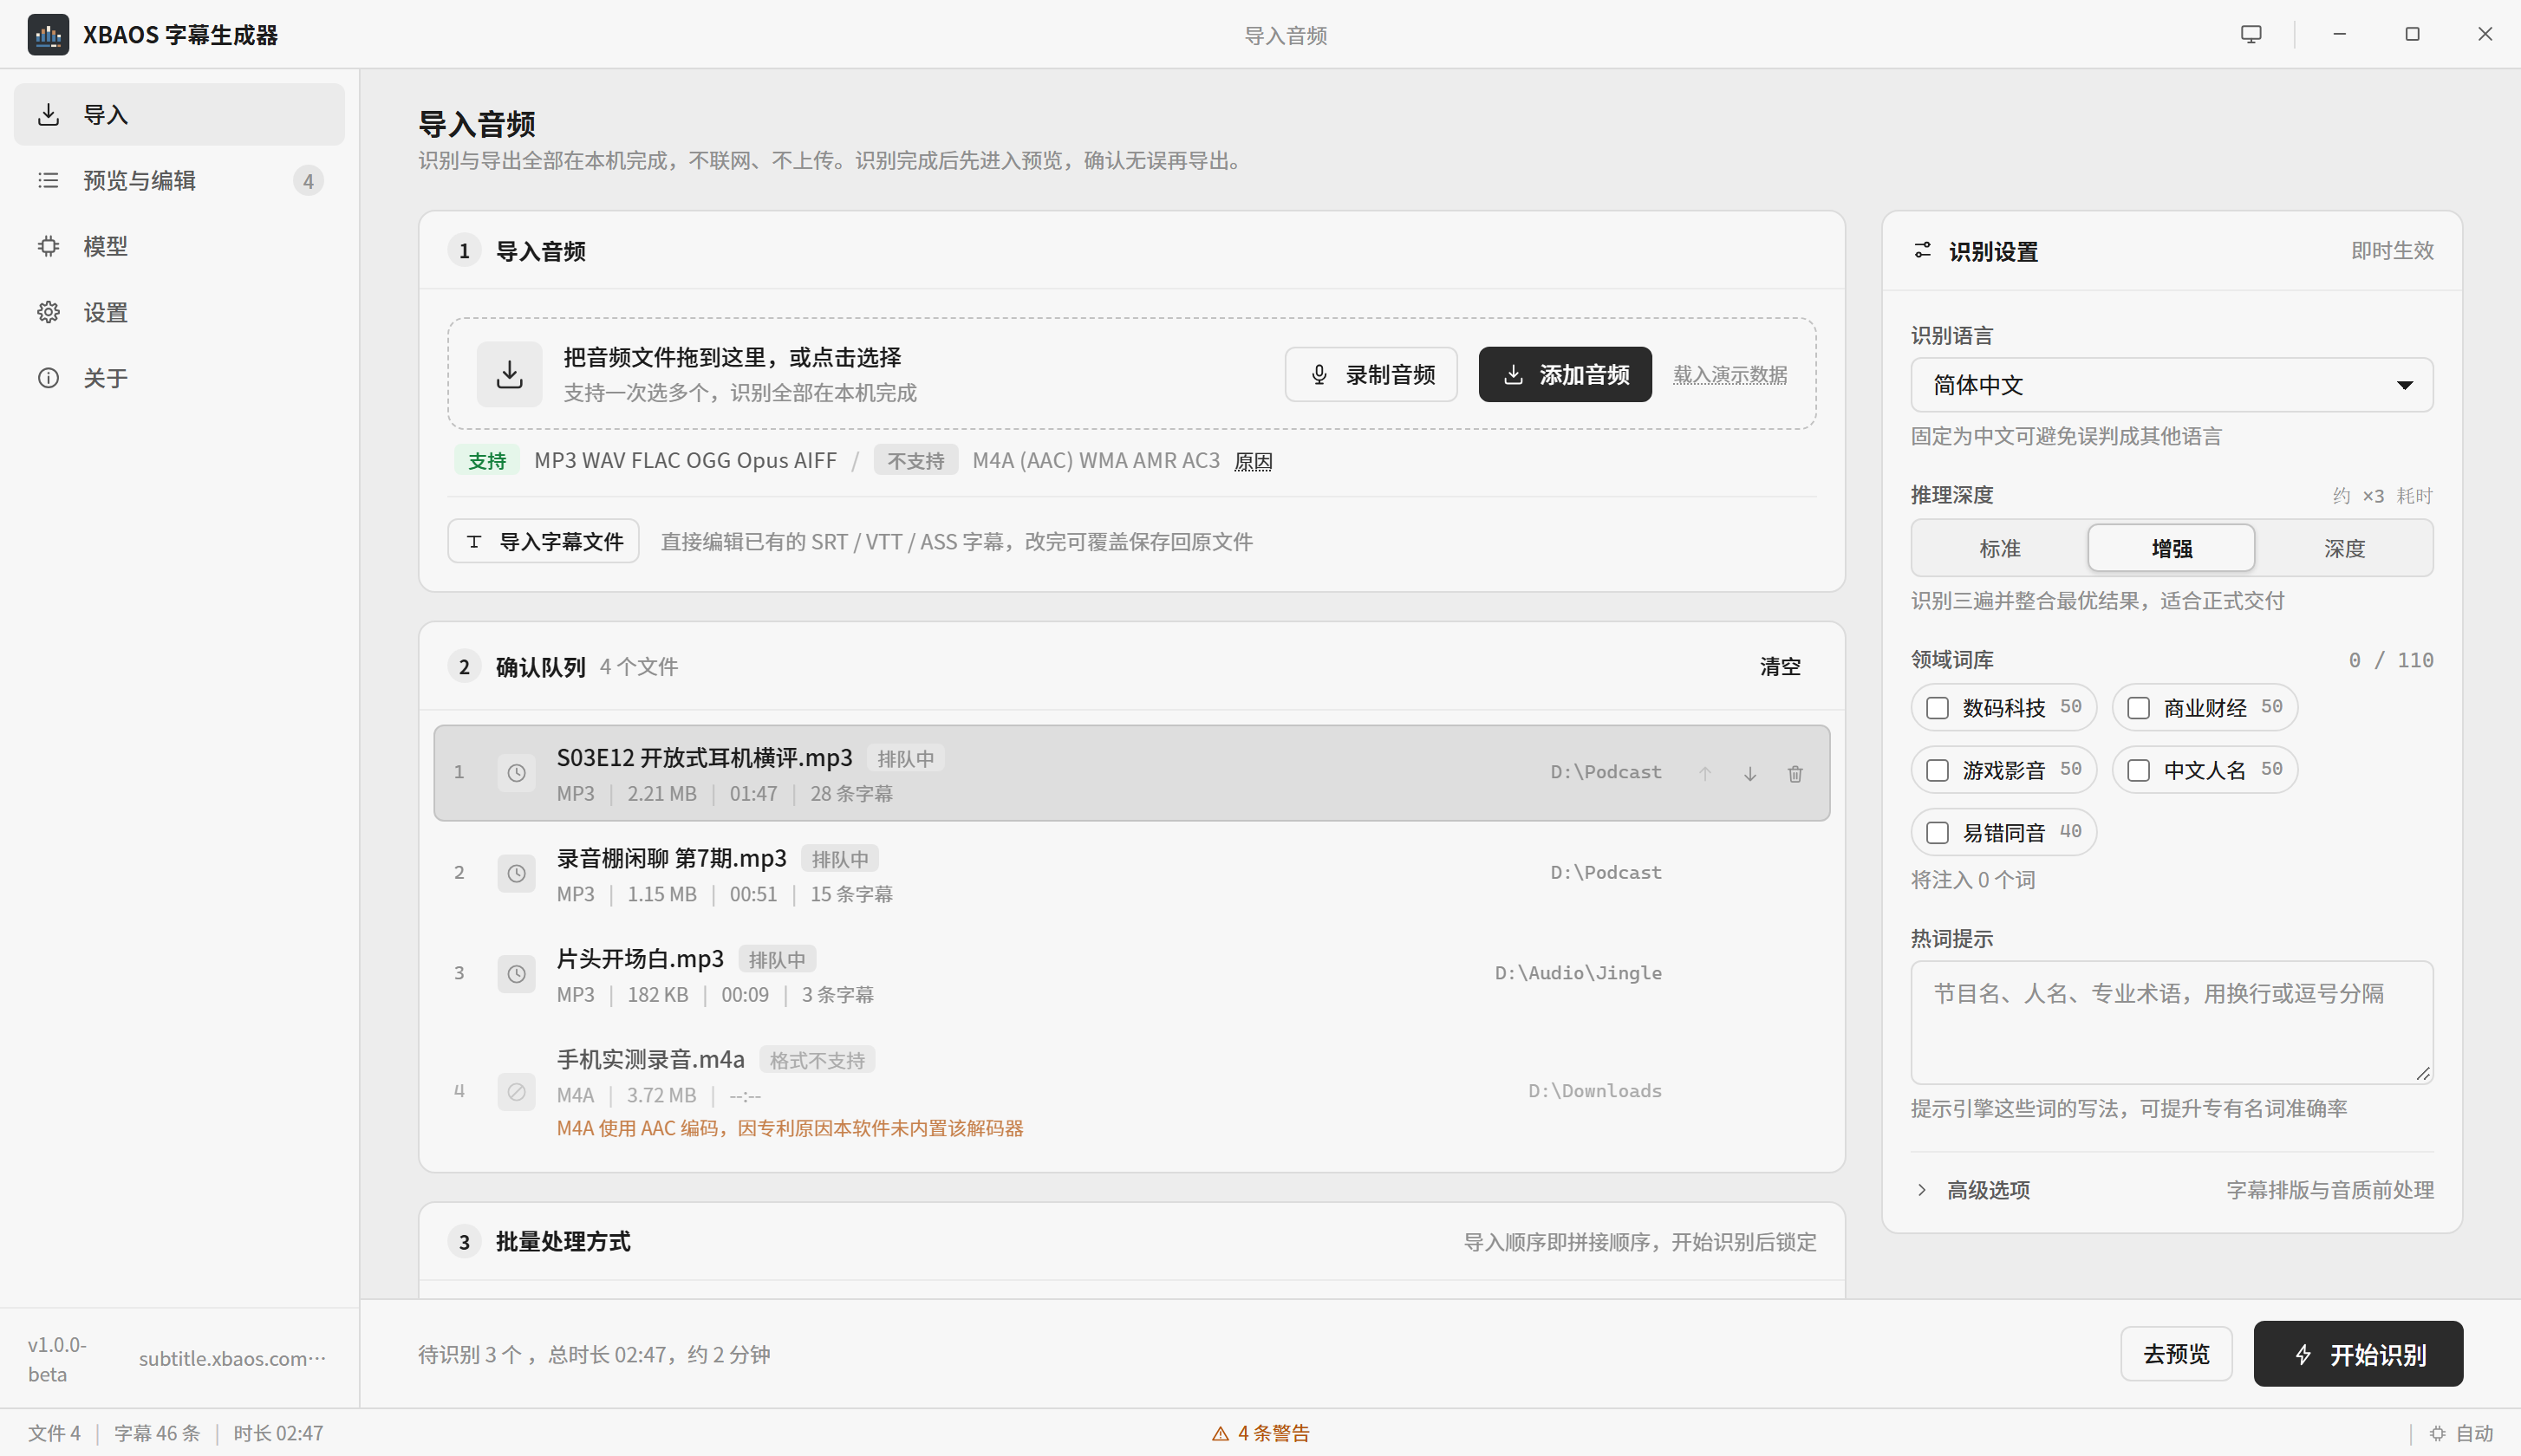
六种音频格式直接读,不用先转格式。识别语言、推理深度、领域词库、 字幕规格都在同一屏里,改完立刻生效,不用来回翻页面。
- MP3、WAV、FLAC、OGG Vorbis、Opus、AIFF
- 长音频按语音活动自动切段,减少漏句
- 五个领域词库与自定义热词
AI 校对,软件本身不联网
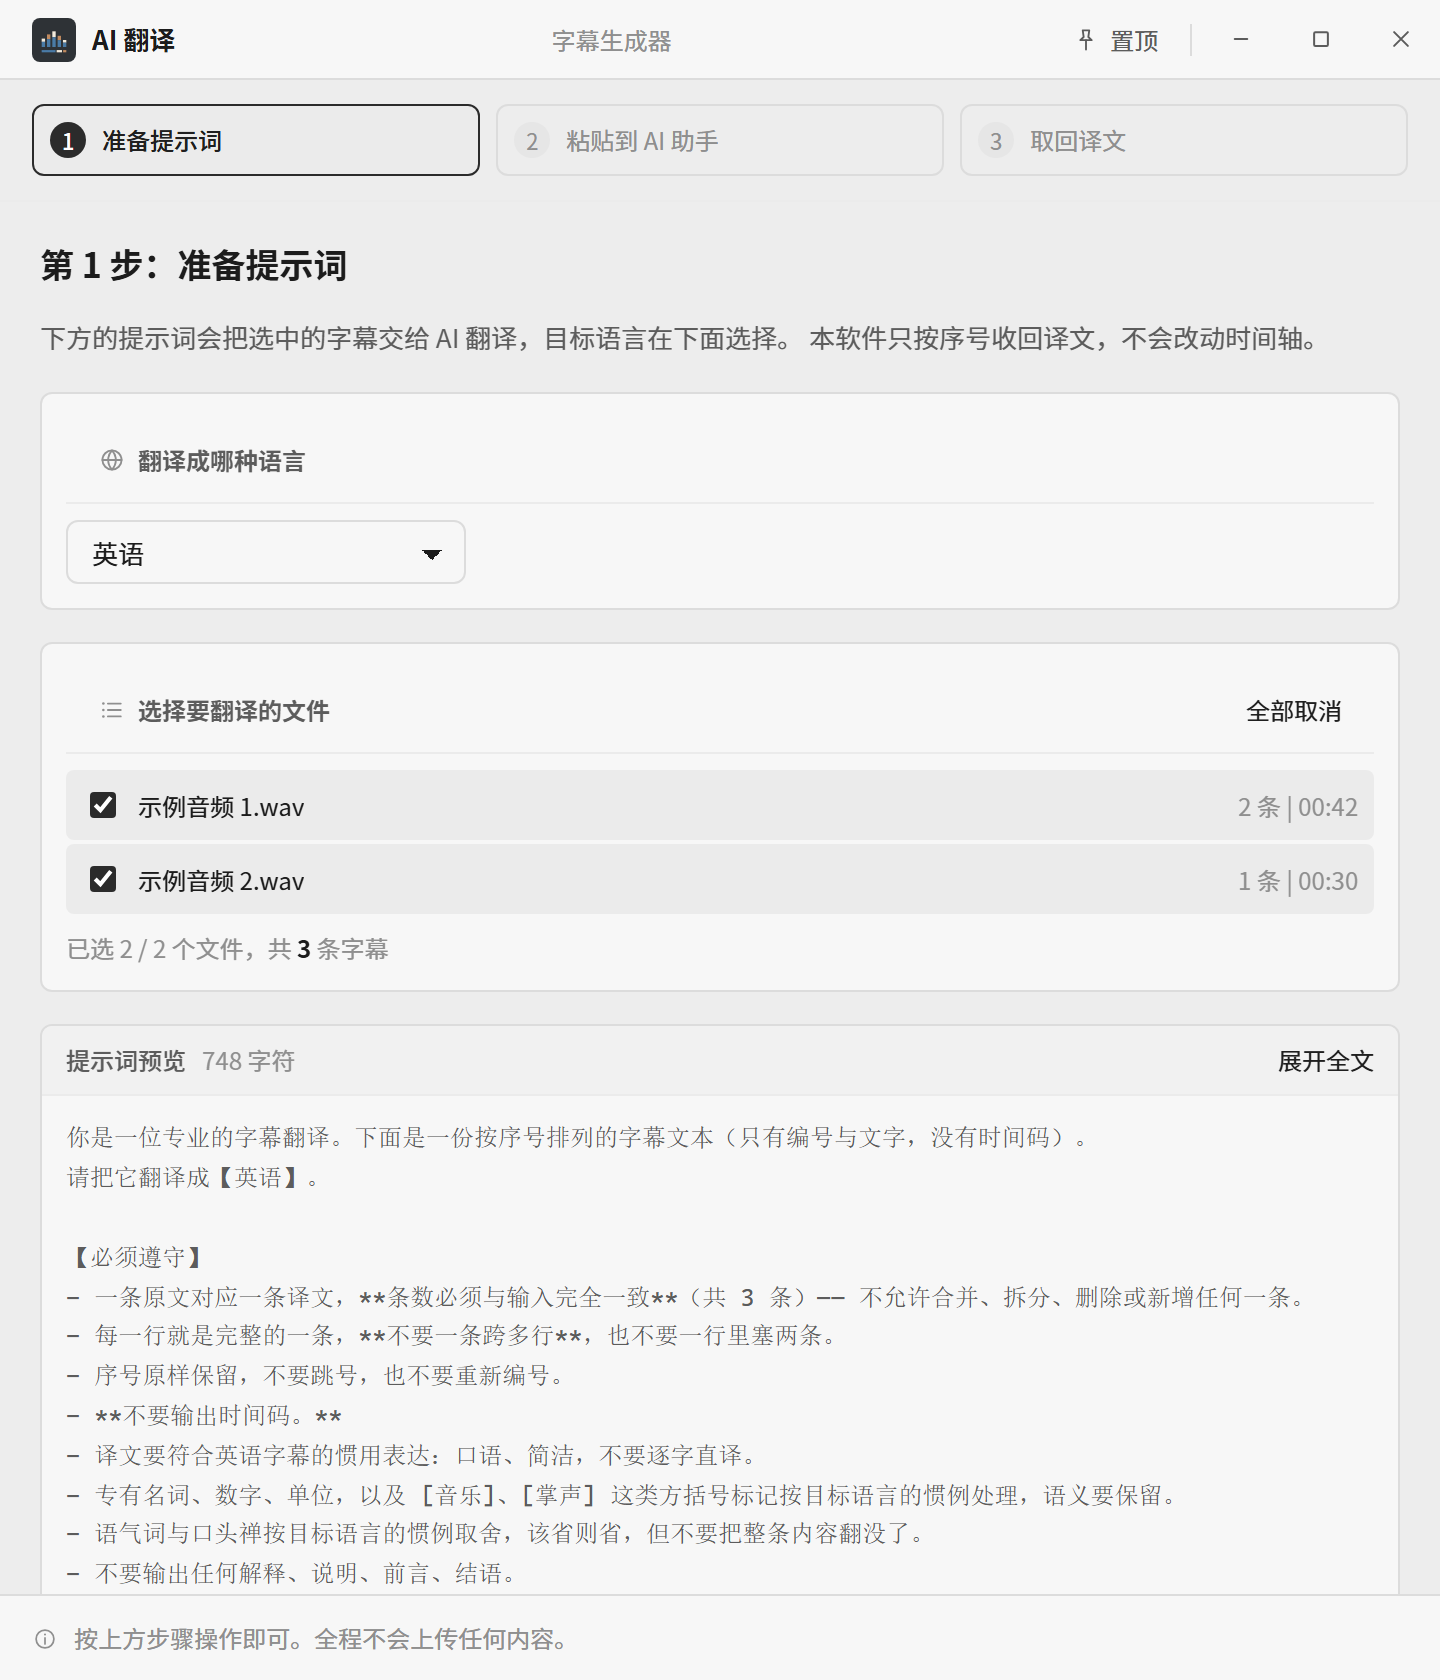
提示词按你本地的设置现拼,经系统剪贴板交给你自己选的网页版大模型, 结果再复制回来一键覆盖。联网的是你的浏览器,不是这个软件。
- 标点习惯、字幕规格、勾选的词库都会反映进提示词
- 取回时先给出逐条预览,确认无误再写回字幕
- 改错了 Ctrl+Z 能整体撤回
模型自己选,大小自己定
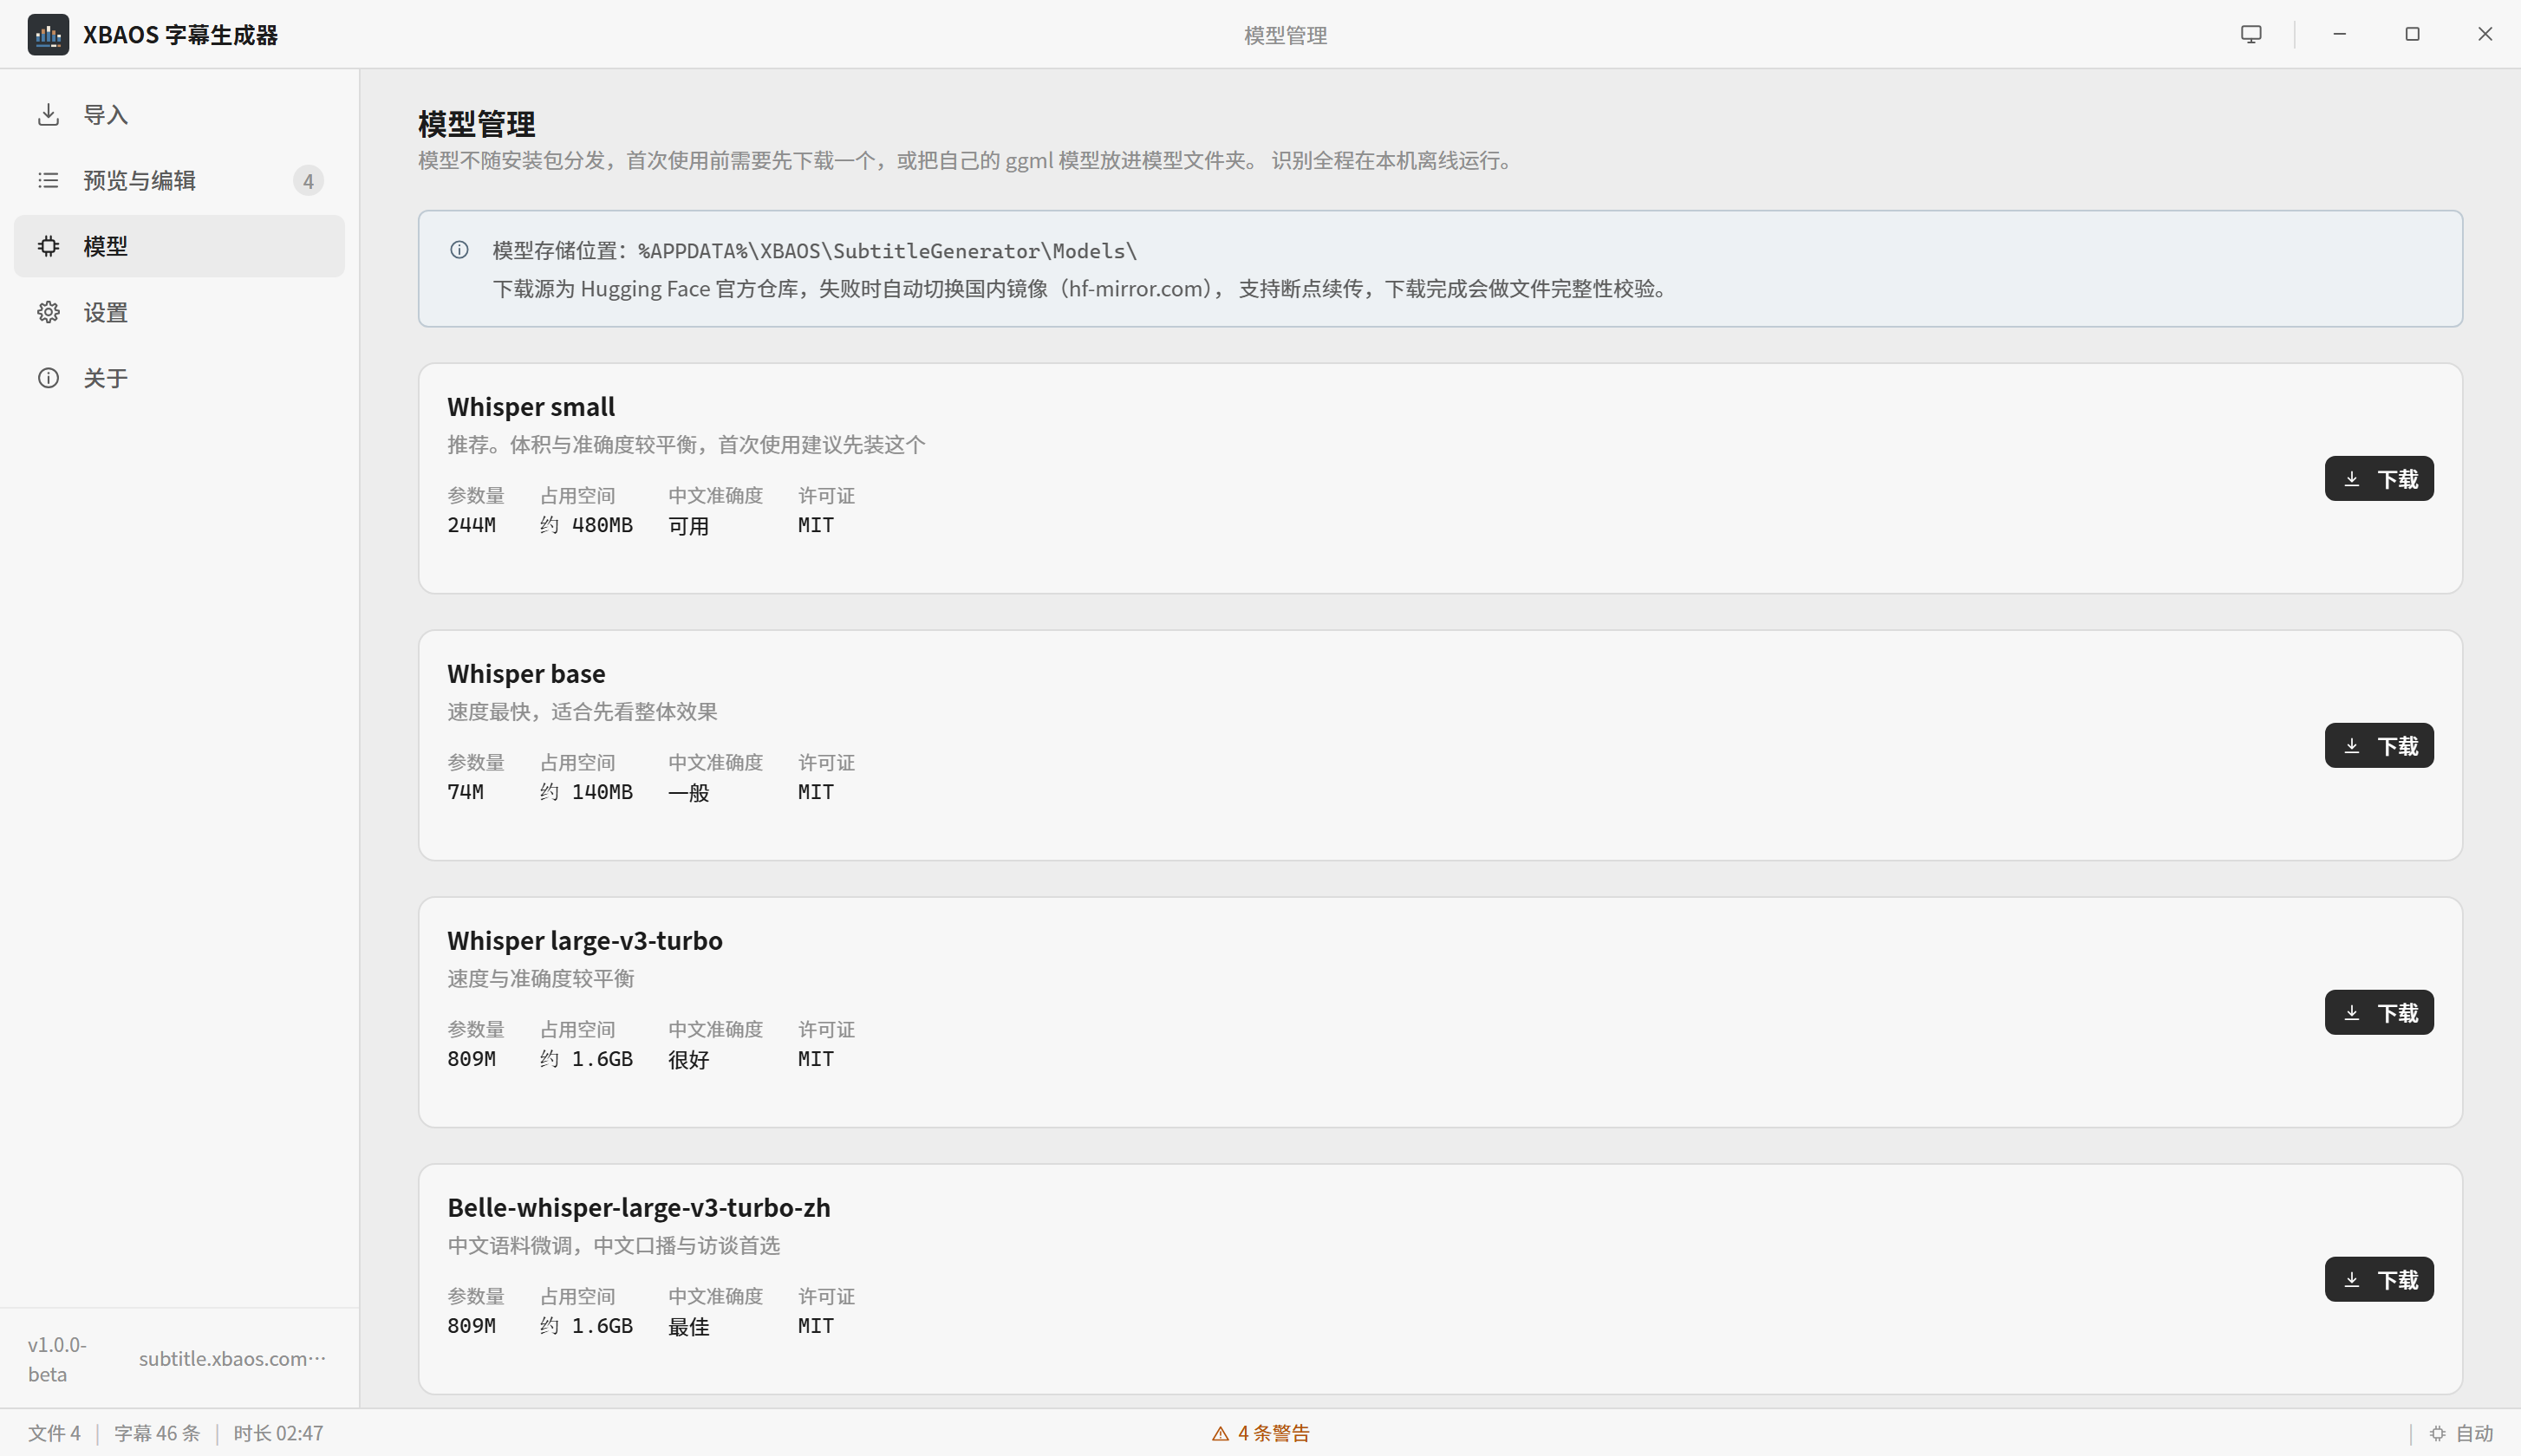
安装包不再内置模型,首次启动会带你到模型页配置。想快就选小的, 想准就换大的;也可以把自己手头的 ggml 模型放进文件夹,软件一样认得。
- 模型名不限定,任何 .bin 都能被识别
- 模型目录可以整个换到别的盘
- 识别全程离线,装好之后断网也能用
- 剪辑式时间轴
- 六类字幕规格校验
- SRT / VTT / ASS / TXT 导出
- UTF-8 / 带 BOM / GBK 编码
- 15 步撤回重做
- 查找替换与批量文本工具
下载
下载安装包
当前是公开测试版。安装包未做数字签名,首次运行 Windows 可能提示「未知发布者」, 选择「更多信息」后再点「仍要运行」即可。
XBAOS 字幕生成器
识别模型不随安装包分发,需要单独获取。软件运行需要 Windows 10 1809 及以上 64 位系统、 建议 8 GB 内存;核显即可运行,支持 Vulkan 的显卡会明显快一截。
常见问题
你可能想先问清楚的事
会上传我的音频吗?
不会。音频的解码与语音识别全部在本机完成,软件不会把音频、片段或识别结果发到任何服务器, 也不包含统计与埋点组件。
软件只有两个地方会联网:你主动点「检查更新」时读取版本清单;你下载识别模型时访问模型仓库。 两件事都可以不用,断网照样能完成识别与导出。
为什么要单独下载模型?
识别模型动辄几百 MB,随安装包分发会让安装包涨到一倍以上。现在安装包约 110 MB, 首次启动时软件会带你到模型页,选一个档位下载,或者把你自己手头的 ggml 模型文件 放进模型文件夹 —— 文件名不限定,软件认后缀。
模型采用 MIT 许可,版权归其各自权利人所有。装好之后识别全程离线,断网也能用。
支持 M4A、AAC 吗?
不支持。AAC 的部分专利尚未到期,软件为了保证完全免费可商用,不内置任何需要付费授权的解码器。 M4A、MP4、WMA、AMR、DTS 同理。
遇到这些格式,先用别的工具转成 MP3、WAV、FLAC、OGG 或 Opus 再导入即可。 导入时软件会直接告诉你原因,不会默默失败。
软件收费吗?可以商用吗?
免费,可商用。软件不含任何需要付费授权的组件,也没有需要付费授权的音频解码实现, 内置的识别引擎与所用模型权重均为 MIT 许可。
完整的第三方组件与许可清单在软件的「关于」页里,可以逐条核对。 源代码依 Apache 2.0 开源。